如果把AI数据中心比作一座城市,GPU集群是日夜运转的工厂,那么光模块就是连接工厂之间的高速公路。数据以电信号的形式在芯片里出生,又以光信号的形式在光纤中飞奔,到了目的地再变回电信号。完成这场“电—光—电”转换的,是一块比手掌还小的光模块。拆开它,里面并不是某一个“万能芯片”在单打独斗,而是一群角色分明的部件在接力合作。
先看清整块模块的骨架。它大体可以分成三块:电芯片、光芯片和光纤阵列单元。电芯片负责电信号的处理与放大,包括DSP、Driver、TIA;光芯片负责光信号的产生、调制和探测,包括激光器、调制器、光电探测器等;光纤阵列单元则是模块与外部光纤对接的“光口”。理解了这三块的分工,再看信号怎么走,整条链路就清楚了。
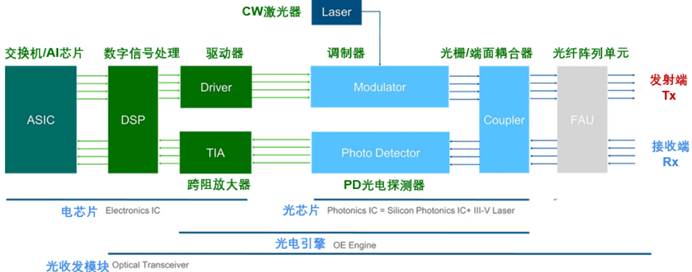
发射方向,是把电信号“写”到光上。交换机或GPU送来的高速电信号,先进入DSP。DSP做的事听起来抽象,但目的很实在:对信号做均衡、前向纠错和数模转换,尽量让数据在高速奔跑中少出错。经过DSP“整理”过的信号,交给Driver放大,再去驱动光调制器。调制器的作用,是把电信号的变化“刻”到一束连续激光上——激光器本身只提供稳定的光源,真正承载信息的是调制器对光的“改写”。调制完成后的光信号,经过耦合器进入光纤阵列单元,从光口输出,汇入光纤网络。
接收方向,则是把光信号“读”回电信号。光从光纤进入模块,先经过光纤阵列单元和耦合器,到达光电探测器。探测器把光转换成微弱电流,但这时候的信号还太“轻”,不足以被后级电路直接使用。接棒的是TIA,也就是跨阻放大器,它把这个微弱电流放大并转换成电压信号。放大后的信号送回DSP,由DSP完成采样、时钟恢复和解码,最终还原成ASIC能读懂的数字信号。整条链路的分工原则可以概括成一句话:DSP管“算账”,Driver和TIA管“放大”,调制器和探测器管“光电转换”,光纤阵列单元管“对准光纤”。
这条链路上有六个关键的“交接点”。其中,ASIC与DSP之间的板级高速电接口,是传统可插拔光模块最大的瓶颈之一;电芯片与光芯片之间的高频互连,则是CPO等技术重点优化的位置;而光芯片与光纤阵列单元之间的耦合对准,直接关系到封装良率和耦合损耗,是整个产业公认的硬骨头。换句话说,光模块的演进史,很大程度上就是一部“缩短高速电链路、优化光电交接面”的历史。
沿着这个逻辑,就能看懂LPO、NPO和CPO为什么会出现。传统可插拔光模块保留了DSP,电接口损耗大、功耗偏高。LPO选择拿掉DSP,让Driver直接驱动调制器,链路简化了,功耗也随之下降;但光电引擎仍然放在交换机前面板,高速电信号要在PCB上走几十厘米。NPO把光电引擎搬到ASIC封装旁边,高速电链路从几十厘米缩短到厘米级,同时保留插座式安装,坏了可以单独更换,不必连带换掉昂贵的ASIC。CPO则更进一步,把光电引擎和ASIC共封装在同一基板或中介层上,电链路缩到毫米级,代价是光电引擎与ASIC深度绑定,维修难度和良率风险都更高。
产业界已经用实际动作投票。2026年被普遍视为CPO的量产元年,英伟达和博通相继发布CPO交换机产品,台积电的硅光整合平台也计划进入量产。英伟达在GTC2026上发布了将于下半年量产的Quantum3400CPO交换机,并联合供应链伙伴大幅扩张CPO光引擎产能。Intel则在更早的时候就押注硅光,其硅光产品组合覆盖400G、800G和1.6T,硅光平台累计出货已超过800万颗PIC、3200万颗片上激光器。这些数字背后是一个清晰的趋势:硅光方案在800G模块中的占比已接近一半,在1.6T时代有望进一步成为主导选择。
回过头再看那块小小的光模块,DSP、Driver、TIA、PIC、FAU各司其职,没有哪一个部件能单独完成“电变光、光变电”的往返旅程。真正决定光模块性能、功耗和成本的,往往不是某一个芯片的极限参数,而是这些部件之间的接口——电信号在PCB上多走一厘米,光在耦合面多损失零点几个dB,累积起来就是系统级差距。硅光技术之所以重要,正是因为它把原本分立的光器件集成到硅芯片上,让“接口”有机会从封装边缘一步步挪进芯片内部,甚至挪到ASIC身边。下一次当你听说某款AI芯片集群又刷新了训练纪录时,不妨想一想:在那些看不见的光纤两端,正有无数个DSP、Driver和TIA在默默完成一场又一场电与光的接力。